
TECH & AI
สร้างโครงสร้างพื้นฐานสำหรับโลก AI ที่ไม่หยุดนิ่ง
ไม่มีใครในอุตสาหกรรมนี้ตอบได้ว่า AI จะมีหน้าตาเป็นอย่างไรในอีก 5 ปีข้างหน้า ไม่มีใครรู้ว่าสถาปัตยกรรมโมเดลใดจะก้าวขึ้นมาเป็นผู้นำ ไม่มีใครรู้ว่าสัดส่วนระหว่างการเทรนและการอนุมาน (Inference) จะไปหยุดอยู่ที่จุดใด และไม่มีใครรู้ว่า AI จะทำงานอยู่ในดาต้าเซ็นเตอร์ของคุณ ในดาต้าเซ็นเตอร์ของคนอื่น หรือบนแล็ปท็อป (หรือแม้แต่อุปกรณ์ที่เล็กกว่านั้น) มากน้อยแค่ไหน แต่ถึงอย่างนั้น ผู้นำด้านโครงสร้างพื้นฐานยังคงต้องตัดสินใจและลงทุนตั้งแต่วันนี้ เพื่อวางรากฐานด้านไอทีให้กับธุรกิจไปอีก 5-7 ปีข้างหน้า
นี่คือความท้าทาย ความจริงก็คือ ความเสี่ยงสูงสุดไม่ใช่การเลือกเทคโนโลยีผิดในวันนี้ แต่เป็นการสร้างโครงสร้างพื้นฐานที่ไม่สามารถปรับตัวรับความต้องการที่เปลี่ยนไปเมื่อเวิร์กโหลดพัฒนาขึ้นไปในวันข้างหน้า
ในงาน AI Infra Summit ที่ผ่านมา ผมได้นำเสนอว่าเราจำเป็นต้องคิดใหม่เกี่ยวกับการออกแบบโครงสร้างพื้นฐาน AI ซึ่งไม่ควรยึดติดอยู่กับชิปหรือเทคโนโลยีเครือข่าย แต่ควรตั้งอยู่บนคำถามพื้นฐานที่ว่า: เมื่อความต้องการเปลี่ยนไป ระบบจะปรับตัวได้ง่ายเพียงใด?
ความสามารถในการปรับตัว: หัวใจหลักของการออกแบบ
ไม่กี่ปีก่อน “โครงสร้างพื้นฐาน AI” มักหมายถึงการรันโมเดลเทรนนิ่งขนาดใหญ่บนคลัสเตอร์เดียว ซึ่งสร้างความต้องการทรัพยากรแบบ batch ที่คาดเดาได้ แม้เวิร์กโหลดลักษณะนี้จะยังสำคัญ แต่วันนี้ระบบต้องรองรับทั้ง Inference, Agentic AI และเวิร์กโหลดที่กระจายตัวมากขึ้น ซึ่งล้วนมีข้อกำหนดที่แตกต่างกันอย่างสิ้นเชิง
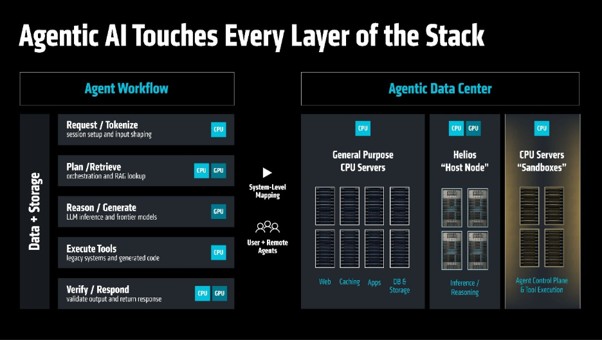
Inference ต้องทำงานอยู่ตลอดเวลา โดยให้ความสำคัญกับค่าความหน่วง (latency) และต้นทุนต่อคำขอ ส่วน Agentic AI ยิ่งเพิ่มความซับซ้อน เพราะคำขอเดียวอาจแตกออกเป็นหลายขั้นตอน ทั้งการดึงและจัดรูปแบบข้อมูลอินพุต การเรียกใช้เครื่องมือ การรันโค้ด การประสานงาน sub-agent รวมถึงการรักษาสถานะที่มีอายุยาวนานกว่าคำขอทั่วไป
สิ่งนี้ไม่เพียงเปลี่ยนปริมาณทรัพยากรประมวลผลที่ต้องการ แต่ยังเปลี่ยน “รูปแบบ” ของระบบด้วย โครงสร้างพื้นฐานที่ปรับแต่งมาเพื่อคลัสเตอร์เทรนนิ่งในอดีตไม่ได้แค่ขาดแคลนความจุ แต่ยังมีรูปแบบที่ผิดเพี้ยนไป สมดุลระหว่างการประมวลผล หน่วยความจำ และเครือข่ายที่เคยสร้างไว้ ไม่สอดคล้องกับทิศทางที่เวิร์กโหลดเกิดขึ้นจริงอีกต่อไป และคุณไม่สามารถแก้ปัญหารูปแบบระบบนี้ได้เพียงแค่เพิ่มสิ่งที่คุณมีอยู่แล้วเข้าไป
กุญแจสำคัญคือการเพิ่มประสิทธิภาพทั้งระบบ ไม่ใช่แค่องค์ประกอบใดองค์ประกอบหนึ่ง การประมวลผล หน่วยความจำ เครือข่าย สตอเรจ ซอฟต์แวร์ พลังงาน และความเสถียร ต้องทำงานร่วมกันอย่างราบรื่น การขยายระบบที่คุ้นเคยเป็นเพียงเรื่องของการจัดสรรงบประมาณ แต่การเปิดรับสถาปัตยกรรมใหม่คือความท้าทายด้านการออกแบบและการปฏิบัติการอย่างแท้จริง
3 คุณสมบัติเพื่อรักษาอิสระในการเลือก
เมื่อความต้องการเปลี่ยนไปตลอดเวลา เป้าหมายของการออกแบบจึงไม่ใช่การทำนายผู้ชนะ แต่เป็นการรักษาอิสระที่จะก้าวไปสู่เทคโนโลยีขั้นต่อไป ซึ่งในทางปฏิบัติสามารถประเมินได้จาก 3 คุณสมบัติหลัก ดังนี้:
- ปรับตัวได้ (Adaptable): คุณต้องมีพอร์ตโฟลิโอที่ครอบคลุมมากพอ เพื่อให้เมื่อเวิร์กโหลดเปลี่ยนไป ทางออกคือการปรับเปลี่ยนคอนฟิกูเรชัน ไม่ใช่การเปลี่ยนผู้จำหน่าย เลือกใช้ขุมพลังประมวลผลให้เหมาะกับงาน ภายใต้รากฐานซอฟต์แวร์ร่วมที่ช่วยให้การสับเปลี่ยนตัวเลือกเหล่านั้นเกิดขึ้นได้จริง
- คุ้มค่าเชิงเศรษฐศาสตร์ (Economical): คำนี้ไม่ได้หมายถึงราคาถูก แต่หมายถึงการเลือกลงทุนในเครื่องมือที่ใช่ การเทรนโมเดลคือการลงทุนที่เกิดขึ้นนาน ๆ ครั้ง แต่ inference คือต้นทุนการดำเนินงานที่เกิดขึ้นนับพันล้านครั้งต่อวัน และคำขอแบบ agentic ก็ไม่ใช่ inference เพียงครั้งเดียว แต่เป็นเครือข่ายที่เชื่อมโยงกัน ดังนั้น สิ่งที่ควรให้ความสำคัญคือ “ต้นทุนต่องานที่สำเร็จ” ไม่ใช่ต้นทุนต่อโทเคน
- เปิดกว้าง (Open): ระบบนิเวศแบบเปิดมอบทางเลือกผ่านการใช้มาตรฐานที่ได้รับการยอมรับอย่างกว้างขวาง ช่วยให้ลูกค้าไม่ต้องผูกติดกับโรดแมปผลิตภัณฑ์ของผู้จำหน่ายรายใดรายหนึ่ง นี่คืออิสระในการเลือกซัพพลายเออร์ที่แท้จริง และเป็นเหตุผลว่าทำไมการเชื่อมต่อและเครือข่ายแบบเปิดจึงมีความสำคัญ
บทบาทของกลุ่มผลิตภัณฑ์ AMD
นี่คือเหตุผลที่ความครอบคลุมของเทคโนโลยีมีความสำคัญ และเป็นเหตุผลที่ AMD เลือกลงทุนอย่างครบถ้วนทั้ง สแตกเทคโนโลยี แทนที่จะพึ่งพาผลิตภัณฑ์ชูโรงเพียงชิ้นเดียว ความต้องการด้าน AI ในปัจจุบันครอบคลุมตั้งแต่:
- การทำ inference,tokenization, orchestration และการประมวลผลอเนกประสงค์อื่น ๆ บนโปรเซสเซอร์ AMD EPYC™ Server ไปจนถึงโมเดลขนาดเล็กและ AI ในเครื่อง (local AI) บนแพลตฟอร์ม AMD Radeon™ และ AMD Ryzen™ AI
- การทำ inference และ fine-tuning สำหรับโมเดลภาษาขนาดใหญ่บนกราฟิกการ์ด AMD Instinct™ PCIe
- การทำ distributed inference และการเทรนโมเดลบนระบบกราฟิกการ์ด AMD Instinct™ แบบ 8-way ซึ่งขยายสเกลไปสู่โซลูชัน AMD Helios™ ระดับตู้แร็คเพื่อรองรับการติดตั้งระดับ Mega-scale
ผลิตภัณฑ์เดี่ยว ๆ ไม่ใช่ประเด็นหลัก ความครอบคลุมที่ปราศจากซอฟต์แวร์ร่วมก็เป็นเพียงแค่แค็ตตาล็อกสินค้า แต่ความครอบคลุมที่ผสานกับซอฟต์แวร์คือความยืดหยุ่น ด้วย AMD ROCm™ software ที่เป็นรากฐานร่วม คุณสามารถโยกย้ายฮาร์ดแวร์ของเวิร์กโหลดได้โดยไม่ต้องเริ่มต้นนับหนึ่งใหม่
เราสร้างสรรค์เทคโนโลยีครอบคลุมทั้งสแตก เพราะเชื่อว่าแต่ละองค์ประกอบต้องพิสูจน์ความยอดเยี่ยมด้วยตัวมันเอง ไม่ใช่เพราะระบบจะทำงานได้ก็ต่อเมื่อคุณเหมาซื้อทั้งหมด มาตรฐานแบบเปิดคือสิ่งที่ทำให้แนวคิดนี้เป็นจริง: คุณสามารถเลือกองค์ประกอบของ AMD ที่เหมาะที่สุดกับเวิร์กโหลดของคุณ ในขณะที่ยังคงอิสระในการเลือกใช้โซลูชันอื่น ๆ จากที่อื่นได้อย่างเต็มที่
องค์กรที่จะประสบความสำเร็จในอีก 5 ปีข้างหน้า จะไม่ใช่องค์กรที่คาดเดาทุกการเปลี่ยนแปลงได้ถูกต้อง แต่จะเป็นองค์กรที่มีอิสระและความยืดหยุ่นมากพอที่จะปรับเปลี่ยนทิศทางเมื่อเวลานั้นมาถึง
สร้างให้ปรับตัวได้ เพื่อให้อนาคตไม่ว่าจะมาในรูปแบบใดก็ยังรองรับได้ สร้างอย่างคุ้มค่า เพื่อให้คุณจ่ายกับเครื่องมือที่เหมาะสม ไม่ใช่เครื่องมือที่ใหญ่ที่สุด และสร้างบนพื้นฐานแบบเปิด เพื่อรักษาทางเลือกเอาไว้ เพราะเมื่อคุณไม่มีทางเลือก คุณย่อมต้องจ่ายต้นทุนของมัน
จงสร้างระบบให้ ปรับตัวได้ เพื่อรับมือกับอนาคตไม่ว่าจะมาในรูปแบบใด จงสร้างให้ คุ้มค่า เพื่อจ่ายให้กับเครื่องมือที่ใช่ ไม่ใช่เครื่องมือที่ใหญ่ที่สุด และจงสร้างบนพื้นฐานที่ เปิดกว้าง เพื่อรักษาทางเลือกเอาไว้ เพราะหากคุณทิ้งสิทธิ์นั้นไป คุณย่อมต้องจ่ายต้นทุนที่ตามมา
สิ่งเดียวที่เรารับประกันได้คือ AI จะยังคงเปลี่ยนแปลงต่อไป และเราควรเริ่มสร้างโครงสร้างพื้นฐานโดยตั้งอยู่บนสมมติฐานนี้ตั้งแต่แรก
บทความโดย Alexey Navolokin ผู้จัดการทั่วไปประจำภูมิภาคเอเชียแปซิฟิก (APAC)